В админке сайта есть раздел «Трафик»: просмотры, визиты, источники, страны, устройства, время на странице. Метрика на сайте тоже стоит, и заменять её я не собирался. Хотелось другого - держать сырые просмотры в своей базе, рядом со статистикой скачиваний резюме, чтобы вопрос «из какого источника приходят те, кто резюме открывает» решался запросом, а не сверкой двух чужих отчётов.
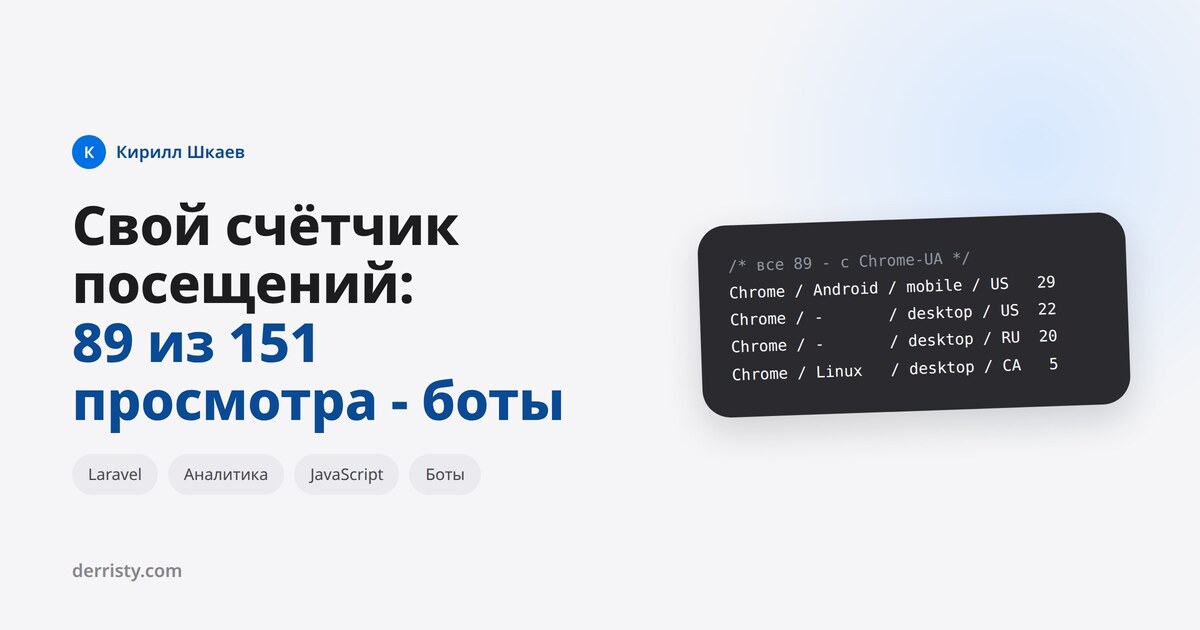
Писать просмотры я решил из браузера, а не серверным middleware, и главным доводом было вот это: боты JS не исполняют, значит краулеры, сканеры и монитор аптайма в статистику не попадут сами. Через три недели в таблице лежало 151 просмотр, из них 89 - с поднятым флагом бота. Довод оказался неверным. Трекинг из браузера при этом остался, и ниже - почему, плюс пять остальных ловушек, на которые я наступил по дороге.
Устройство: браузер присылает адрес, остальное сервер берёт сам
В общий шаблон подключён небольшой скрипт. Он делает один POST при показе страницы и второй, маленький, при уходе с неё:
fetch('/analytics/pageview', {
    method: 'POST',
    headers: { 'Content-Type': 'application/json' },
    body: JSON.stringify({
        url: window.location.pathname,
        referrer: document.referrer || '',
        lang: navigator.language || '',
        client_id: clientId(),
    }),
    credentials: 'same-origin',
})
    .then(function (r) { return r.json(); })
    .then(function (d) { pvId = d && d.id ? d.id : null; })
    .catch(function () {});
Сервер отвечает идентификатором созданной записи - он понадобится, чтобы дописать в неё время на странице. Строка ложится в таблицу page_views: адрес, язык, реферер и его тип, IP, страна, устройство, браузер, ОС, utm-метки, идентификатор сессии и браузера.
Правило, которое я держал с самого начала: из тела запроса беру только то, что знает один браузер - путь, реферер, язык, utm-метки, идентификатор из localStorage. IP, User-Agent, страну и сессию сервер берёт у себя. Тело подделывается тривиально, соединение - нет. Идентификатор браузера при этом ещё и проверяется на формат:
private function clientId(Request $request): ?string
{
    $cid = (string) $request->input('client_id', '');

    return preg_match('/^[0-9a-f]{8}-[0-9a-f]{4}-[0-9a-f]{4}-[0-9a-f]{4}-[0-9a-f]{12}$/i', $cid)
        ? strtolower($cid)
        : null;
}
Без проверки в колонке рано или поздно окажется чужая строка на 500 символов. Сам идентификатор живёт в localStorage, а не в сессии: сессия истекает за пару часов, и вернувшийся через день посетитель считался бы новым. В приватном режиме localStorage бросает исключение - там просто остаёмся без сквозного идентификатора, это нормальный режим работы, а не ошибка.
Ловушка 1: боты исполняют JS
Это главное, что я узнал. Разбор 89 ботских записей по разобранному User-Agent:
Chrome / Android / mobile / US   29
Chrome / -       / desktop / US  22
Chrome / -       / desktop / RU  20
Chrome / Linux   / desktop / CA   5
Chrome / Windows / desktop / US   4
Chrome / macOS   / desktop / CA   4
Chrome / Android / mobile / CA    3
Ни одного curl, ни одного python-requests. Всё - браузеры на движке Chrome, треть из них мобильные, и больше половины с американских адресов. То есть JS исполняли именно поисковые краулеры: Google рендерит страницы в Chrome уже лет десять, Яндекс тоже, и превью-краулеры мессенджеров туда же. Заходили они, кстати, осмысленно: 67 раз на главную и 9 раз на последнюю статью - ровно ту, что была свежей.
Вывод простой и неприятный: браузерный трекинг отсекает скрипты, но не краулеры. Фильтр по User-Agent нужен ровно так же, как в серверном варианте. У меня он уже был написан для статистики резюме, и я переиспользовал тот же список маркеров - иначе на сайте было бы два разных представления о том, кто тут бот.
Отдельно - моя же ошибка в схеме. В page_views нет колонки с сырым User-Agent: только флаг и разобранные поля. Колонку bot_name я в миграции завёл, а писать в неё забыл. В итоге я знаю, что запись ботская, но не знаю, чей это бот, и восстанавливаю это по стране и разбору. Если делать заново - сохранял бы сырой User-Agent хотя бы для тех записей, где флаг поднят: места это почти не занимает, а разбор всегда можно переделать только на будущих данных.
Ловушка 2: Chrome открывает страницы заранее
Браузер предугадывает переходы и подгружает страницу до клика. JS в предзагруженной странице исполняется, а человек её не видел - и счётчик получает просмотр, которого не было. Лечится штатным API:
if (document.prerendering) {
    document.addEventListener('prerenderingchange', registerView, { once: true });
} else if (document.visibilityState === 'hidden') {
    document.addEventListener('visibilitychange', function onVisible() {
        if (document.visibilityState !== 'hidden') {
            document.removeEventListener('visibilitychange', onVisible);
            registerView();
        }
    });
} else {
    registerView();
}
Две ветки, потому что случаи разные: document.prerendering - это именно предрендер, а скрытая вкладка бывает и от фонового открытия по средней кнопке мыши. Просмотр регистрируем только в момент реального показа.
И тут же вторая деталь: отсчёт времени на странице должен начинаться не при загрузке скрипта, а при показе. Поэтому start = Date.now() стоит внутри registerView. Иначе страница, предзагруженная за пять минут до клика, отдаст пять минут «чтения».
Ловушка 3: один показ, две записи
Повторный вызов на той же странице случается и без вашего участия: возврат по кнопке «назад» поднимает страницу из bfcache, а в некоторых сценариях скрипт срабатывает дважды за один показ. Дубли ловятся коротким окном:
$duplicate = PageView::where('session_id', $sessionId)
    ->where('url', $url)
    ->where('created_at', '>=', now()->subSeconds(5))
    ->value('id');

if ($duplicate) {
    return response()->json(['id' => $duplicate]);
}
Важна не только проверка, но и ответ: возвращаем прежний идентификатор, а не null. Иначе пинг с временем на странице уйдёт в пустоту и запись останется без времени.
Ловушка 4: эндпоинт открыт, и это не мелочь
Проверку CSRF для двух адресов трекинга пришлось снять - иначе просмотр не запишется со страницы, отданной из кеша с просроченным токеном. Плата за это очевидна: любой может звать эндпоинт курлом и накручивать счётчик. Минимум, который я поставил - источник запроса и лимит частоты:
private function fromOwnSite(Request $request, string $host): bool
{
    $source = $request->headers->get('Origin') ?: $request->headers->get('Referer');

    if (! $source) {
        return false;
    }

    $sourceHost = strtolower((string) parse_url($source, PHP_URL_HOST));

    return $sourceHost !== ''
        && preg_replace('/^www\./', '', $sourceHost) === preg_replace('/^www\./', '', strtolower($host));
}
Плюс throttle:120,1 на маршруте. Скажу честно: от целенаправленной накрутки это не защищает - заголовки подделываются в одну строку. Это фильтр от шума: случайных сканеров, чужих ботов, дёргающих найденный в исходниках адрес, и собственных ошибок вроде запроса из консоли. Для статистики личного сайта достаточно; для счётчика, по которому платят деньги, нужна подпись запроса.
Ловушка 5: время на странице теряется у каждого третьего
Время отправляется при уходе со страницы, и отправлять его надо не обычным запросом, а маячком - обычный браузер успеет отменить:
var fd = new FormData();
fd.append('pv_id', pvId);
fd.append('time', elapsed);
navigator.sendBeacon('/analytics/ping', fd);
Слушать надо visibilitychange и pagehide, а не unload: unload в Safari не срабатывает и вдобавок мешает bfcache. Но даже с маячком доходит не всё. В моих данных время на странице заполнено у 35 записей из 62 - то есть у 44% человеческих просмотров его нет вообще. Закрыли ноутбук крышкой, убили вкладку, потеряли сеть.
Отсюда два следствия для отчёта. Среднее считать только по заполненным значениям (whereNotNull('time_on_page')), иначе пропуски утянут его вниз. И отказ определять по числу страниц в визите, а не по времени: визит из одной страницы - отказ, а «ноль секунд» чаще всего означает не мгновенный уход, а не доехавший маячок. Среднее по тому, что доехало, у меня 22 секунды.
Ловушка 6: собственные служебные адреса
В топе страниц появились /analytics/pageview и /analytics/ping. Человек их не открывал никогда - это счётчик записал сам себя. Правится одной проверкой:
if (str_starts_with($url, '/analytics/')) {
    return response()->json(['id' => null]);
}
Урок не про трекинг, а про любые самописные метрики: в первый же день откройте отчёт и поищите в нём собственные служебные адреса. Они там будут.
Агрегаты: кеш на десять минут и версия структуры в ключе
Сводка считает около двадцати разрезов, и половина из них - COUNT(DISTINCT session_id). На каждый заход в админку это дорого, поэтому результат кешируется целиком на десять минут, с кнопкой принудительного пересчёта.
А вот грабли, которые ждут любой кешированный отчёт. Я добавил в сводку новые поля - тепловую карту по часам и точки входа. Код готов, вьюха готова, а страница падает с Undefined variable $heatmap: отчёт уходит во вьюху массивом и разворачивается в переменные, а из кеша приходит структура, собранная старой версией метода, и новых ключей в ней нет. Живёт это ровно до истечения TTL, и именно поэтому выглядит как привидение. Лечение - версия структуры прямо в ключе:
/** Меняется при добавлении полей в data(): старый кеш тогда просто не читается */
private const STRUCTURE_VERSION = 'v2';

public function cached(?Carbon $from, ?Carbon $to, bool $fresh = false): array
{
    $key = 'traffic_report_'.self::STRUCTURE_VERSION.'_'
        .md5(($from?->toDateString() ?? 'all').'|'.($to?->toDateString() ?? 'all'));
    ...
}
Меняешь набор полей - меняешь константу, и старые записи просто перестают читаться. Это надёжнее, чем помнить про cache:clear в деплое.
Две другие вещи в отчёте я тоже сделал не сразу. Первая: в кеше лежат обычные массивы, а не Eloquent-коллекции. Строки агрегатов - это не записи таблицы, модель им не нужна, а в кеше она лишний вес и лишняя привязка к классу, который ещё будет меняться. Вторая: отказы и точки входа считает база, а не PHP:
$singlePage = DB::query()->fromSub(
    $human()->select('session_id')->groupBy('session_id')->havingRaw('COUNT(*) = 1'),
    'single'
)->count();
Соблазн выгрузить сессии в коллекцию и посчитать в PHP велик, но на периоде в год это десятки тысяч значений в памяти и в IN (...). Подзапрос делает то же самое, не вынося данные из базы.
Что вышло
За три недели: 62 человеческих просмотра, 49 визитов, 38 уникальных браузеров. Источники - 47 переходов напрямую, 7 внутренних, 6 с внешних сайтов и 2 из поиска. Масштаб, на котором о выводах говорить смешно, - и ровно поэтому хорошо видно устройство: на таких числах каждая ложная запись заметна поимённо, а на сайте с миллионом просмотров и prerender, и собственные служебные адреса растворились бы в шуме.
Если делать такой счётчик заново, порядок был бы такой. Фильтр ботов по User-Agent - сразу, а не после первой сводки. Сырой User-Agent в базу - хотя бы для ботских записей. Регистрация просмотра только по факту показа - с первого дня, а не когда в отчёте появятся странные тридцатиминутные «чтения». И версия структуры в ключе кеша - до того, как отчёт первый раз покажут кому-то ещё.