Худший способ узнать, что сервис лежит, - сообщение от клиента. Второй по качеству - открыть сайт самому и увидеть, что он работает. Оба ответа говорят о состоянии в одну случайную секунду, а доступность это вопрос про все остальные секунды тоже.
Десять дней назад я поднял для своих проектов самописный аналог UptimeRobot и с тех пор он сделал 347 тысяч проверок. Ниже - что эти цифры показали и какие вещи в мониторинге оказались неочевидными.
Три уровня проверки отвечают на разные вопросы
«Сервер доступен» - слишком общая формулировка, чтобы её проверять. Разложить её стоит минимум на три вопроса, и у каждого свой инструмент.
ICMP-ping отвечает, есть ли маршрут до машины и жива ли она. Не отвечает вообще ни на что про сервисы: сервер может пинговаться, пока веб-сервер лежит.
TCP-порт отвечает, слушает ли демон. Это уже про конкретный сервис: 443 у веб-сервера, 5432 у базы, 22 у ssh. Но открытый порт не значит, что за ним работающее приложение.
HTTP-запрос отвечает, отдаёт ли приложение то, что должно. Самая дорогая и самая содержательная проверка.
У меня на 26 мониторов приходится 7 пингов, 17 портов и 2 HTTP-проверки. Портов больше всего не случайно: они дёшевы, их можно ставить пачками на каждый сервис машины, и по картине «какие порты отвалились» сразу видно, легла машина целиком или один демон.
Ответ 200 не означает, что всё работает
Типовая ловушка: страница отдаёт код 200, а внутри «Ошибка подключения к базе». Мониторинг зелёный, пользователи видят ошибку. Поэтому HTTP-проверка должна смотреть не только на код.
В моём чекере на это два поля: ожидаемый код и ключевое слово в теле ответа.
if ($monitor->expected_code && $code !== (int) $monitor->expected_code) {
    return CheckResult::down("Код ответа {$code}, ожидался {$monitor->expected_code}", ...);
}

if ($monitor->keyword && ! str_contains($response->body(), $monitor->keyword)) {
    return CheckResult::down("В ответе нет слова «{$monitor->keyword}»", ...);
}
Вторая половина той же задачи - на стороне приложения. В Laravel начиная с 11 версии есть готовый health-эндпоинт, он включается одной строкой:
->withRouting(
    web: __DIR__.'/../routes/web.php',
    health: '/up',
)
Но по умолчанию он доказывает ровно одно: PHP запустился и фреймворк загрузился. База, кэш и очередь при этом могут лежать. Если хочется, чтобы зелёный статус что-то значил, эндпоинт должен трогать зависимости:
Route::get('/health', function () {
    DB::connection()->getPdo();                 // база отвечает
    Cache::store()->put('healthcheck', 1, 10);  // кэш пишется
    return response('ok');
});
Здесь есть предел, за который лучше не заходить: health-эндпоинт не должен превращаться в интеграционный тест. Он проверяет то, без чего приложение бесполезно, и не ходит во внешние API - иначе чужая недоступность будет ронять ваш статус.
Большинство «падений» - это моргания
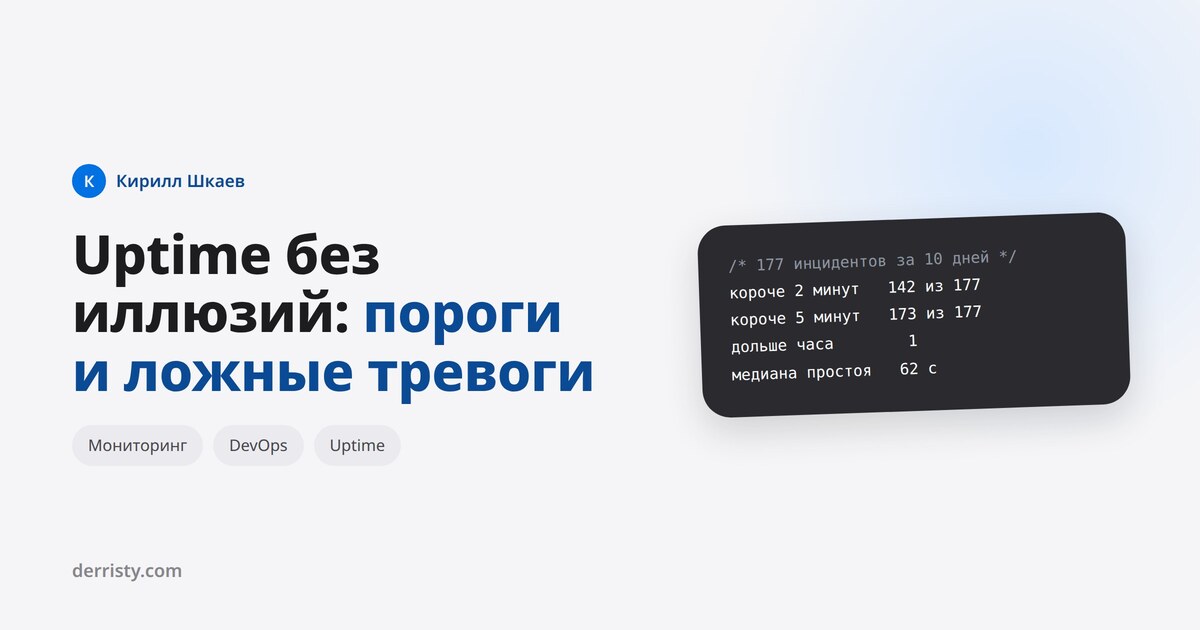
Вот цифра, которая меняет отношение к мониторингу. За 10,5 дней мои мониторы зафиксировали 177 инцидентов. Из них:
короче 2 минут   142 из 177
короче 5 минут   173 из 177
дольше часа        1
Медиана простоя - 62 секунды. То есть восемь из десяти «аварий» закончились раньше, чем на них можно было бы отреагировать. Если слать уведомление на каждую, телеграм превращается в шум, а шум перестают читать - и настоящую аварию вы пропустите ровно так же, как без мониторинга.
Лечится это порогом: сколько неудач подряд нужно, чтобы завести инцидент. При интервале в минуту порог 2 отсекает почти все одиночные таймауты ценой минуты задержки. Я осознанно поставил 1, потому что мне важнее скорость, но платой стали как раз эти 142 короткие записи.
Важная деталь реализации: инцидент открывается по времени первой неудачи в серии, а не по моменту, когда порог набран. Иначе каждый простой занижается на «порог минус один интервал», и статистика тихо врёт в свою пользу.
Зелёный монитор при сломанной связности
Самый поучительный случай за эти дни. У одного хоста с моего сервера отвалился маршрут до IPv6-сети. Ping и проверки портов покраснели, а HTTP-проверка того же хоста осталась зелёной.
Причина в том, что curl умеет happy eyeballs: пробует оба семейства адресов и молча уходит на IPv4, когда IPv6 не отвечает. А системный ping и stream_socket_client берут первый адрес из резолвера и никуда не откатываются. То есть более умный инструмент замаскировал проблему, а более простые её показали.
Вывод, который я из этого сделал: проверка должна записывать, каким путём она прошла. У меня теперь в каждой записи лежит семейство адресов, и «зелёный по IPv4 при мёртвом IPv6» видно глазами, а не выясняется через полгода.
Кто проверяет проверяющего
У мониторинга есть режим отказа, который не выглядит как отказ: планировщик встал, проверки не идут, уведомлений нет. Тишина неотличима от «всё хорошо».
Защита простая - следить за свежестью последней проверки:
$tolerance = $minInterval * 60 + 30;   // 90 секунд при интервале в минуту
$stale = $lastCheckedAt === null || $lastCheckedAt->diffInSeconds(now()) > $tolerance;
Тридцать секунд запаса здесь не случайны. Проверка пишется в базу не в момент запуска крона, а через несколько секунд, плюс таймаут HTTP. Ровно минутный допуск давал ложную тревогу каждый раз перед следующим прогоном.
И отдельная ловушка: судить о работе планировщика по времени изменения его лог-файла нельзя. Если вывод не перенаправлен в файл, лог остаётся старым при полностью живых проверках. Надёжный признак - свежесть данных, а не свежесть логов.
Уведомления: сервис против сервера
Когда машина уходит целиком, каждый её монитор рапортует о падении отдельно. Пять сервисов на сервере - пять сообщений об одном событии.
Поэтому уведомления у меня копятся до конца прогона, а не уходят сразу: пока проверка идёт, состояние соседних мониторов ещё неизвестно, и отличить «отвалился один сервис» от «легла вся машина» невозможно. В конце прогона правило простое: упали все мониторы группы - одно сообщение про сервер, упал один - сообщение про сервис.
Второй момент, о котором обычно не думают: сбой может совпасть с недоступностью канала уведомлений. Если Telegram не принял сообщение, факт отправки не отмечается, и следующая минута повторяет попытку в пределах суток. Без этого падение, случившееся в неудачный момент, не приходит вообще никогда.
Как читать проценты
Мои десять дней в цифрах: 347 099 проверок, из них 916 неудачных. Доля успешных - 99,736%. Звучит прилично, но эта цифра отвечает на вопрос «какая часть проверок прошла», а не «сколько сервис был недоступен».
Простой считается иначе - суммой инцидентов, и здесь получается 14,8 часа по всем 26 мониторам вместе, из которых почти 9 часов даёт один-единственный случай. Две метрики про одно и то же событие расходятся, и это нормально: одна показывает частоту, другая - тяжесть. Смотреть надо обе, потому что сто коротких морганий и один девятичасовой простой дают похожий процент и совершенно разные последствия.
Кстати, о процентах в SLA. 99,9% в год - это почти 9 часов простоя, 99,99% - 52 минуты. Разница между «три девятки» и «четыре девятки» на бумаге в одну цифру, а в жизни это разные деньги и разная архитектура.
Минимум, который стоит настроить
Если мониторинга нет вообще, порядок такой.
Первое - эндпоинт здоровья, который проверяет базу и кэш, и отдаёт короткий ответ. Второе - внешняя проверка этого эндпоинта раз в минуту с чужой машины: проверка с того же сервера бесполезна, когда сервер и лежит. Третье - уведомление в мессенджер с порогом в две неудачи подряд. Четвёртое - ping и пара ключевых портов, чтобы отличать «сервис умер» от «машина недоступна». Пятое - присмотр за самим мониторингом по свежести данных.
Всё это ставится за вечер и закрывает главный вопрос: вы узнаёте о простое раньше клиента и знаете, что именно сломалось, ещё до того, как открыли ssh.